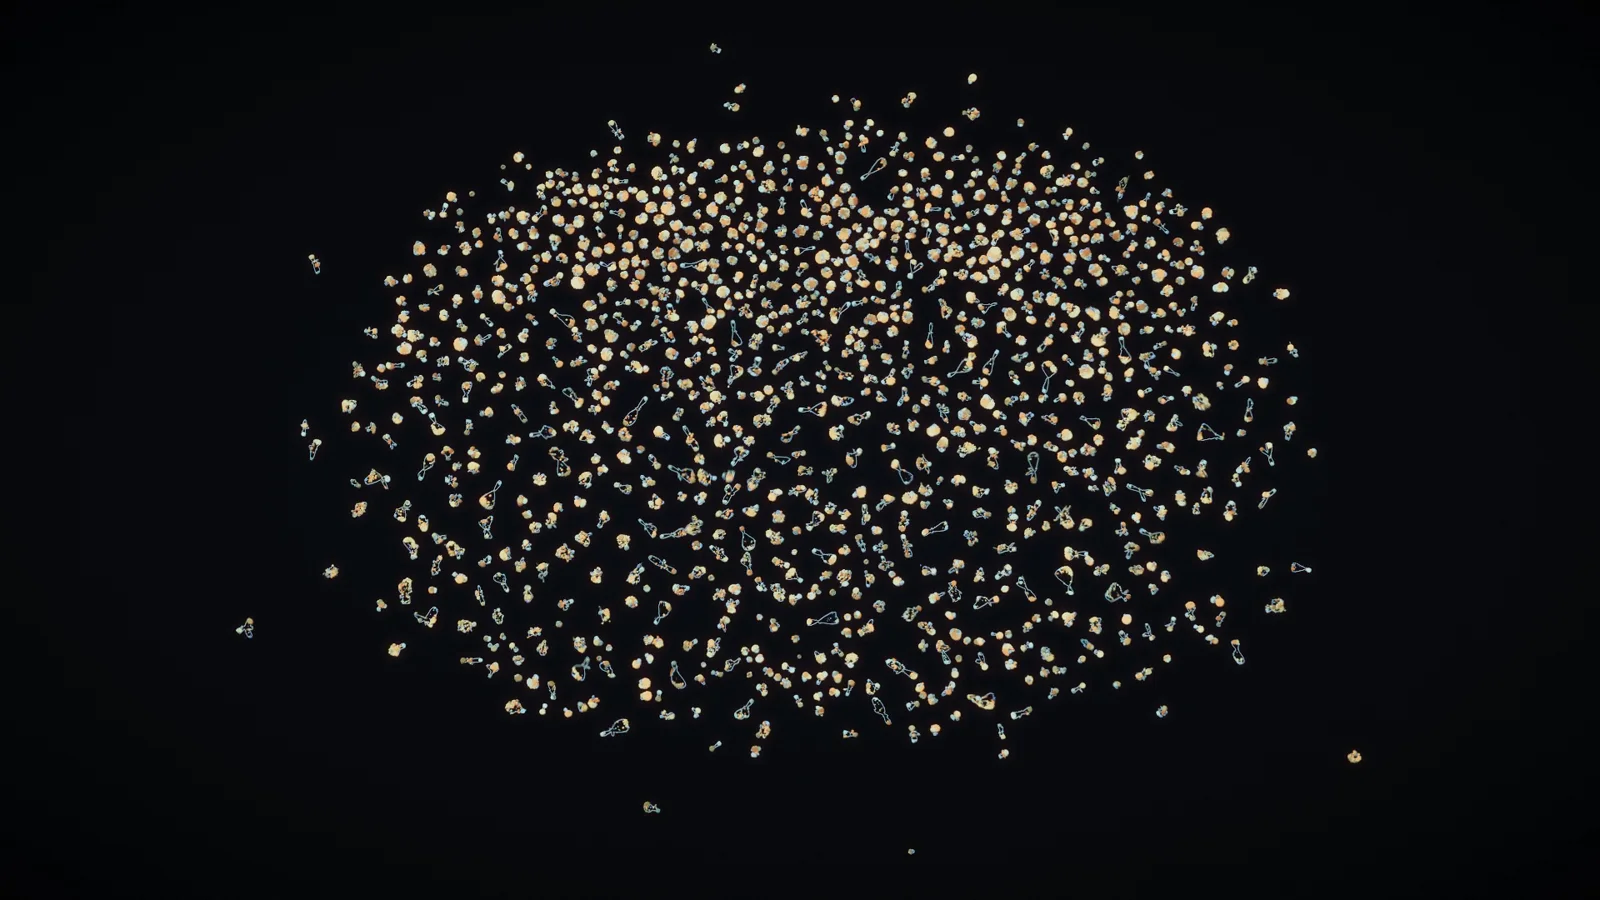
Cellular Group
1,024体の生物、1体あたり256細胞。すべての個体が自前の物理的な膜に包まれ、一つの身体として動く。合計262,144細胞を、同一条件(1024体 × 7000ステップ)で RTX 4090 が 0.400 ms/step、M3 Ultra が 0.398 ms/step —— 60 fps に対して42倍の余裕がある。
設計を支えている一つの発想
1つの GPU ブロックが1個体。256細胞は共有メモリ6KBに収まるので、ブロックは身体全体を一度読み込めば、グローバルメモリに触れずに 256×256 の全対全計算を回せる。近傍探索も空間ハッシュもソートも要らない —— そして1,024という目標個体数は、ハードウェアの並列単位とちょうど一致する。
この写像は Metal でもそのまま成立する。1スレッドグループが1個体、共有メモリの上限は32KBで、使うのは5.4KBだけ。
膜は描かれた輪郭ではなく、物理的なリング
角度ごとの半径 r(θ) を64ビンで持ち、内圧・表面張力・曲げ剛性・面積復元で駆動される。膜がなければ、型ごとの反発が256細胞を16個の別々の塊に引き裂いてしまう —— 膜は後の工程として計画していたが、最初に必要だった。
この膜には長く欠陥が潜んでいた。外殻の推定にビンごとの最大値を使っていたため、膜は最も外れた1細胞を包んでしまう。そして一度その細胞を包んでしまうと、閉じ込め力は二度と発火しない —— はぐれた細胞は居座ることを許される。針状の突起も中身の空いた身体も、どちらもこの一点から出ていた。
ゲノムをランダムに引くのをやめる
各個体は自前のゲノムを持つ —— 大きさ、凝集、反発、膜の張力、目標半径、脈動の深さ、推進力、そして16種の細胞組成。当初これは乱数で引かれていた。いまは探索している。
1回の GPU 実行が1,024個体を同時に評価するということは、1回の実行がまるごと1世代だということでもある。40世代 = 40,960個体の評価が74秒で終わる。ニッチは(伸長 × 直進性 × 体半径)、適応度は「被覆 − 2×膜外流出」。
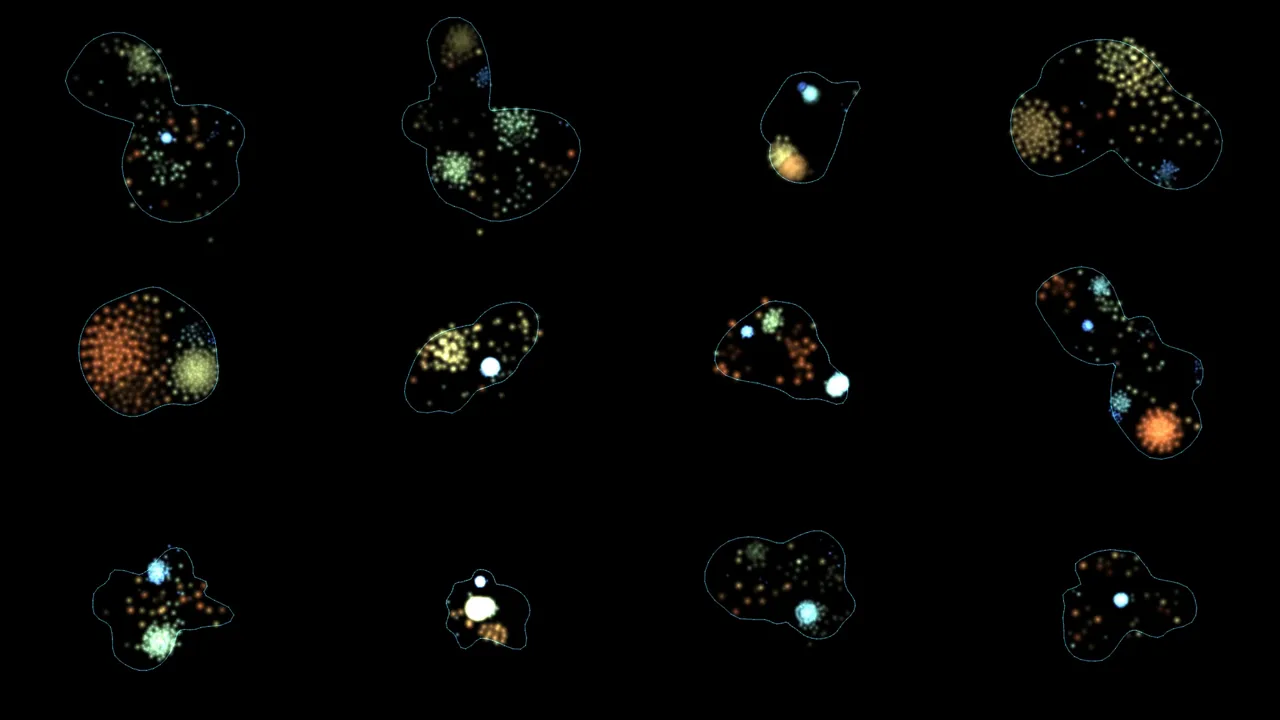
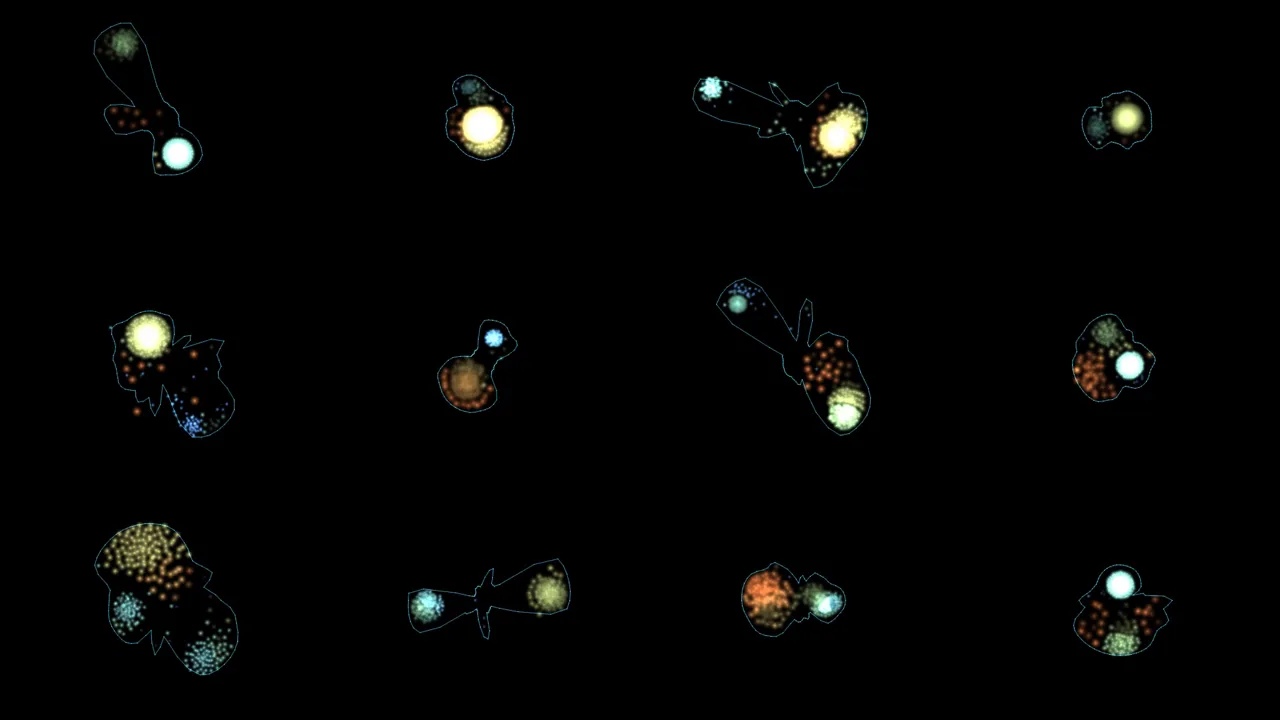
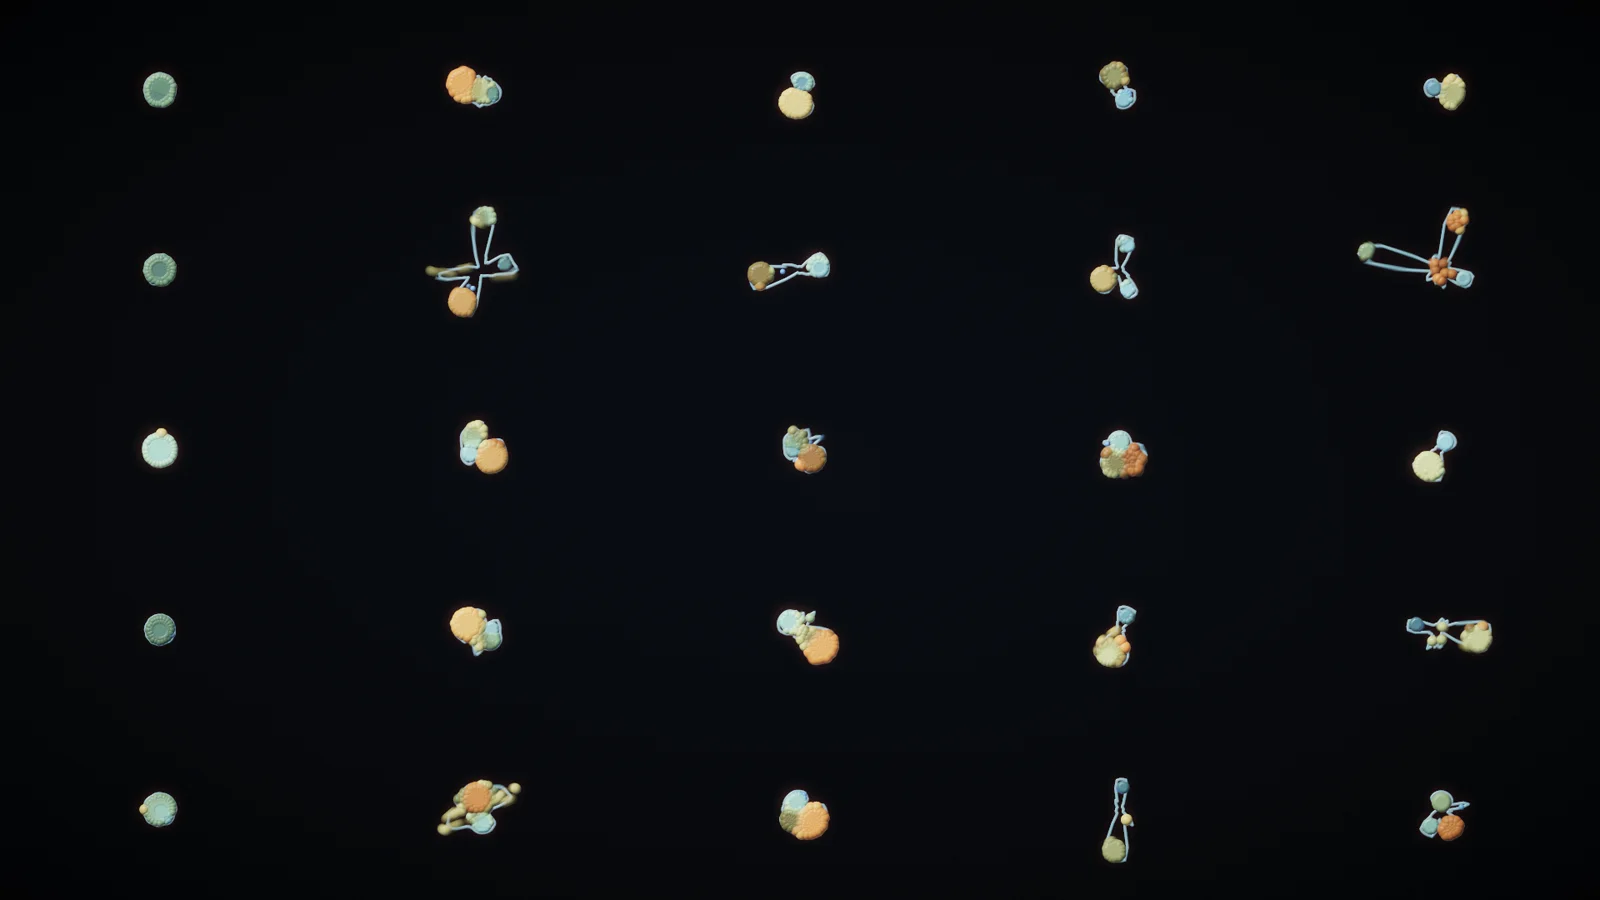
| 指標 | ランダム | 探索後 |
|---|---|---|
| 被覆 — 膜内部が実際に組織で埋まっている割合 | 0.485 | 0.719 |
| 流出 — 自分の膜の外にある細胞 | 8.49% | 7.62% |
| 形状の多様性 | 0.348 | 0.444 |
| サイズの分散 | 6.45 | 9.88 |
直進性が興味深い。どの大域パラメータでも 0.31〜0.47 の帯から出られなかった —— 推進力も旋回も雑音も群間反発も個体数も試した。ゲノム単位でなら 0.602 に届く(膜パラメータを使わない探索のみの構成での値)。ただし推力によってではない。1024個体で測ると、運動性細胞(type 8-11)の割合と直進性の相関は r = +0.002 でまったく関係がない。運動性の割合で四分位に分けても 0.416 / 0.364 / 0.388 / 0.401 と平坦である。効いているのは押されることの方で、群間反発を 3 から 100 に上げると 0.308 が 0.405 になり、混雑は直進性を下げるどころか上げる。個体自身の蠕動は逆に働く(r = −0.170)。
リアルタイムをやめて、光を入れる
映像出力にリアルタイム性は要らない。そこで細胞は加算合成される点であることをやめた。各細胞をスーパーサンプリングしたハイトフィールド上の「照らされた半球」として蓄積すると、高さの勾配から法線が立ち、細胞の塊はバラバラの円板ではなく一つの陰影のある曲面に融合する。その上にアンビエントオクルージョン、マーチングによる方向性ソフトシャドウ、サブサーフェススキャタリング、ブルーム、フィルミックトーンマップ、モーションブラー。
ここでも数値ではなく絵が誤りを教えた。サブサーフェスがシルエットの外で全開になっていて(外側は厚みが0で exp(0)=1)、全個体がオレンジのハローを被っていた。アンビエントオクルージョンの半径はセル半径の3倍で、谷を彫る代わりに面全体を暗くしていた。どちらも指標には現れない。
ゲノムのどこが効いているのか
同じ抽選ゲノムを使い、指定した部分だけを母集団平均に置き換えて測ると、寄与が分解できる。1024個体、v1.1 条件。
| 条件 | サイズ分散 | 形の多様性 | 被覆 |
|---|---|---|---|
| 抽選されたゲノムそのまま | 6.449 | 0.348 | 0.485 |
| 種構成だけ平坦化 | 5.501 | 0.266 | 0.619 |
| スカラー7つだけ平坦化 | 5.573 | 0.349 | 0.458 |
| 両方平坦化 | 3.660 | 0.295 | 0.606 |
形の多様性は種構成がほぼ単独で担っている。スカラーを7つとも平坦にしても 0.348 から 0.349 と動かないのに、種構成を平坦にすると 0.266 まで落ちる。サイズ分散は逆で、種構成とスカラーがそれぞれ 0.9 ずつ寄与する。しかも両者は強く相互作用していて、片方ずつなら −0.9 なのに両方だと −2.79 と、単純な和を大きく超える。
種構成を平坦にすると被覆は 0.485 から 0.619 へ大きく上がる。均質な組織の方がよく詰まる。多様性と密度はここでも引っ張り合っている。
1細胞から育てる
これまで個体は常に256細胞で始まっていた。細胞は最初から全部そこにあり、円板状に撒かれた状態から物理が始まる。いまは 1細胞から分裂して育つ。256はもう個体数ではなく容量である。
娘細胞をどのスロットに置くかは、アトミックな「次の空き」カウンタを使わない。分裂回数 d の細胞 i の娘は必ず i + 2d に入る。不変条件 i < 2d が帰納的に成り立つのでスロットは一意で、探索も要らない。アトミックなら3行短く書けたが、どの細胞がどのスロットを取るかが実行順に依存する —— このプロジェクトが一度除去した非決定性がそこから戻ってくる。
分化は追加機能ではなく必要条件だった。娘が母の細胞型をそのまま継ぐと、個体はやがて単一型になる。ペア相互作用表は型の差 |i−j| で引かれ、その対角が表の中で最も強い引力なので、単一型の個体には斥力のペアが一つも存在しない。体を開いた状態に保つものが無くなり、容量の11%、膜半径3.1で潰れる。娘の型をゲノムの構成比から引き直すと60%・19.2まで育つ。
| 条件 | 脱落 | 形の多様性 | サイズ分散 |
|---|---|---|---|
| 発生なし (v1.3) | 0.0762 | 0.4440 | 9.876 |
| 発生あり・探索済み | 0.0418 | 0.3889 | 7.059 |
発生は脱落を半分にし、その代わりに形態の多様性を払う。細胞が外から撒かれて囲い込まれるのではなく、膜の内側で生まれるからだ。被覆率は動かない。ただでは手に入らない交換であり、細胞を体内に留めるコロニーは、体どうしがより似ているコロニーでもある。
個体が棲む媒質
個体は化学物質を分泌する。周囲は Gray-Scott の反応拡散場で、体の上に模様を貼るのではなく 体から模様が育つ。さらに個体は流体を攪拌し、その流れが化学種を運ぶ。2つは別レイヤーではなく結合していて、同心円だった環は流れに引き伸ばされて連続した網目になる。
場はワールド空間ではなくスクリーン空間にある。レンダラは個体ごとに別の変換を持ち、タイル表示では各タイルが別個体への別の窓なので、単一のワールド座標写像が存在しない。その帰結として媒質はタイル境界をまたいで流れる —— 物理的には正しくないが、そのおかげで1枚が「64個の別々の実験」ではなく一つの連続した媒質として読める。
最初の版は2つ間違えていて、どちらも数値では検出できなかった。単色を濃度で掛けると、模様が濃いところ —— つまり個体の真上 —— で白く飽和し、装飾するはずの体を漂白していた。そして個体を種にしている以上濃度は体の上で最大になるので、模様が体を塗り潰していた。いまは2色の間を補間し、場が持つ組織被覆率のチャンネルでマスクして媒質を体の背後に置いている。
それぞれの個体が音を出す
合成パラメータへの変換表は作っていない。膜そのものが波形だからだ。輪郭は64角度の半径として保持されているので、1シミュレーションステップがそのまま音声64サンプルになる。7000ステップは 44.1kHz で 10.16 秒の音になり、その音色は身体が変形していく様子そのものである。
さらに、16種の細胞タイプにはシミュレータ自身が固有周波数を与え、細胞どうしを位相結合させている。振動子バンクは最初から個体の中にある。共振器をその周波数に調律し、各共振の強さを「そのタイプの構成比 × その瞬間の位相ロック度」にした。音高は体の大きさだけが決める。
合成を通さない元波形で測ると、振幅は伸長と r = +0.75 で相関する。葉が1〜2枚の体は振幅にして約40倍大きく、そのエネルギーは最低次の倍音に集まる — 環を1周する山が1〜2個なら、それが第1・第2倍音そのものだからだ。逆に丸い体は極めて静かだが、残った輪郭は細かい表面の凹凸なので、比率としては高次倍音が豊かになる。
CUDA と Metal、同じシミュレーション
CUDA 固有の要素は実質存在しなかった。__shared__、__syncthreads、__constant__、アトミック —— すべて Metal に対応物がある。翻訳ではなく解決が要ったのは2点だけ: Metal は threadgroup アドレス空間に float アトミックを持たない(固定小数点で置き換え)ことと、curand に等価物がない(カウンタベースのハッシュで代替)こと。
| 指標 | CUDA / RTX 4090 | Metal / M3 Ultra |
|---|---|---|
| ms / step | 0.3999 | 0.3982 |
| 被覆 — 膜内部が実際に組織で埋まっている割合 | 0.7130 | 0.7185 |
| 流出 — 自分の膜の外にある細胞 | 7.621% | 7.623% |
| 形状の多様性 | 0.4493 | 0.4440 |
| サイズの分散 | 10.435 | 9.876 |
比較を成立させるため、glibc の rand() を Swift で再実装して Linux 実機と完全一致を確認した。両者は同じ初期状態から始まるので、以後の差は GPU とコンパイラと乱数だけに切り分けられる。サイズの分散を除いて、差はアンサンブルのノイズ床の内側に収まった。サイズの分散だけは両者が本当に分かれる指標で、原因は移植ではなく乱数にある —— CUDA は curand の Philox、Metal はカウンタベースのハッシュを使い、乱数を切ると差は 0.56 から 0.19 に落ちる。
シミュレーションは互角。共有メモリ律速の全対全計算は Apple silicon と相性がいい。レンダラも、膜のスプラットが1ピクセルに数百回の依存アトミック書き込みをしていた欠陥(フレーム時間の67%)を直したあとは 35 ms/フレームで、CUDA の 45 ms より速い。